Elke webshop die we bouwen heeft reviewomgevingen. Een losse omgeving per branch, waar een merchant kan klikken voordat er iets naar productie gaat. Die omgevingen draaien op een kopie van de productiedatabase, want met twintig testproducten en drie neporders test je niets.
Daarmee staan de gegevens van echte klanten op plekken waar ze niet horen. Niet uit slordigheid, maar omdat het de makkelijkste manier is om realistisch te testen. Dit stuk gaat over hoe we dat hebben opgelost. En over de keuze die daarbij het zwaarst weegt: waar het model draait dat de data beoordeelt.
Waarom een kopie van productie een probleem is
Een productiedump bevat namen, adressen, telefoonnummers, e-mailadressen, IP-adressen en de complete bestelhistorie. In een reviewomgeving heeft dat niets te zoeken. De grondslag waarop die gegevens ooit zijn verzameld was het afhandelen van een bestelling, niet het beoordelen van een pull request.
Het gaat ook om aantallen. Een kopie is te overzien. Een omgeving per branch betekent tien of twintig kopieen. Elk met een eigen backup, een eigen logbestand en een eigen groep mensen die erbij kan. Tel daar de dumps op laptops en de screenshots in tickets bij op, en je kunt niet meer aanwijzen waar de gegevens van je klanten staan.
Anonimiseren lost dat bij de bron op. De reviewomgeving krijgt data die zich gedraagt als echte data, maar die niet naar echte mensen leidt.
Anonimiseren is vooral een kolomprobleem
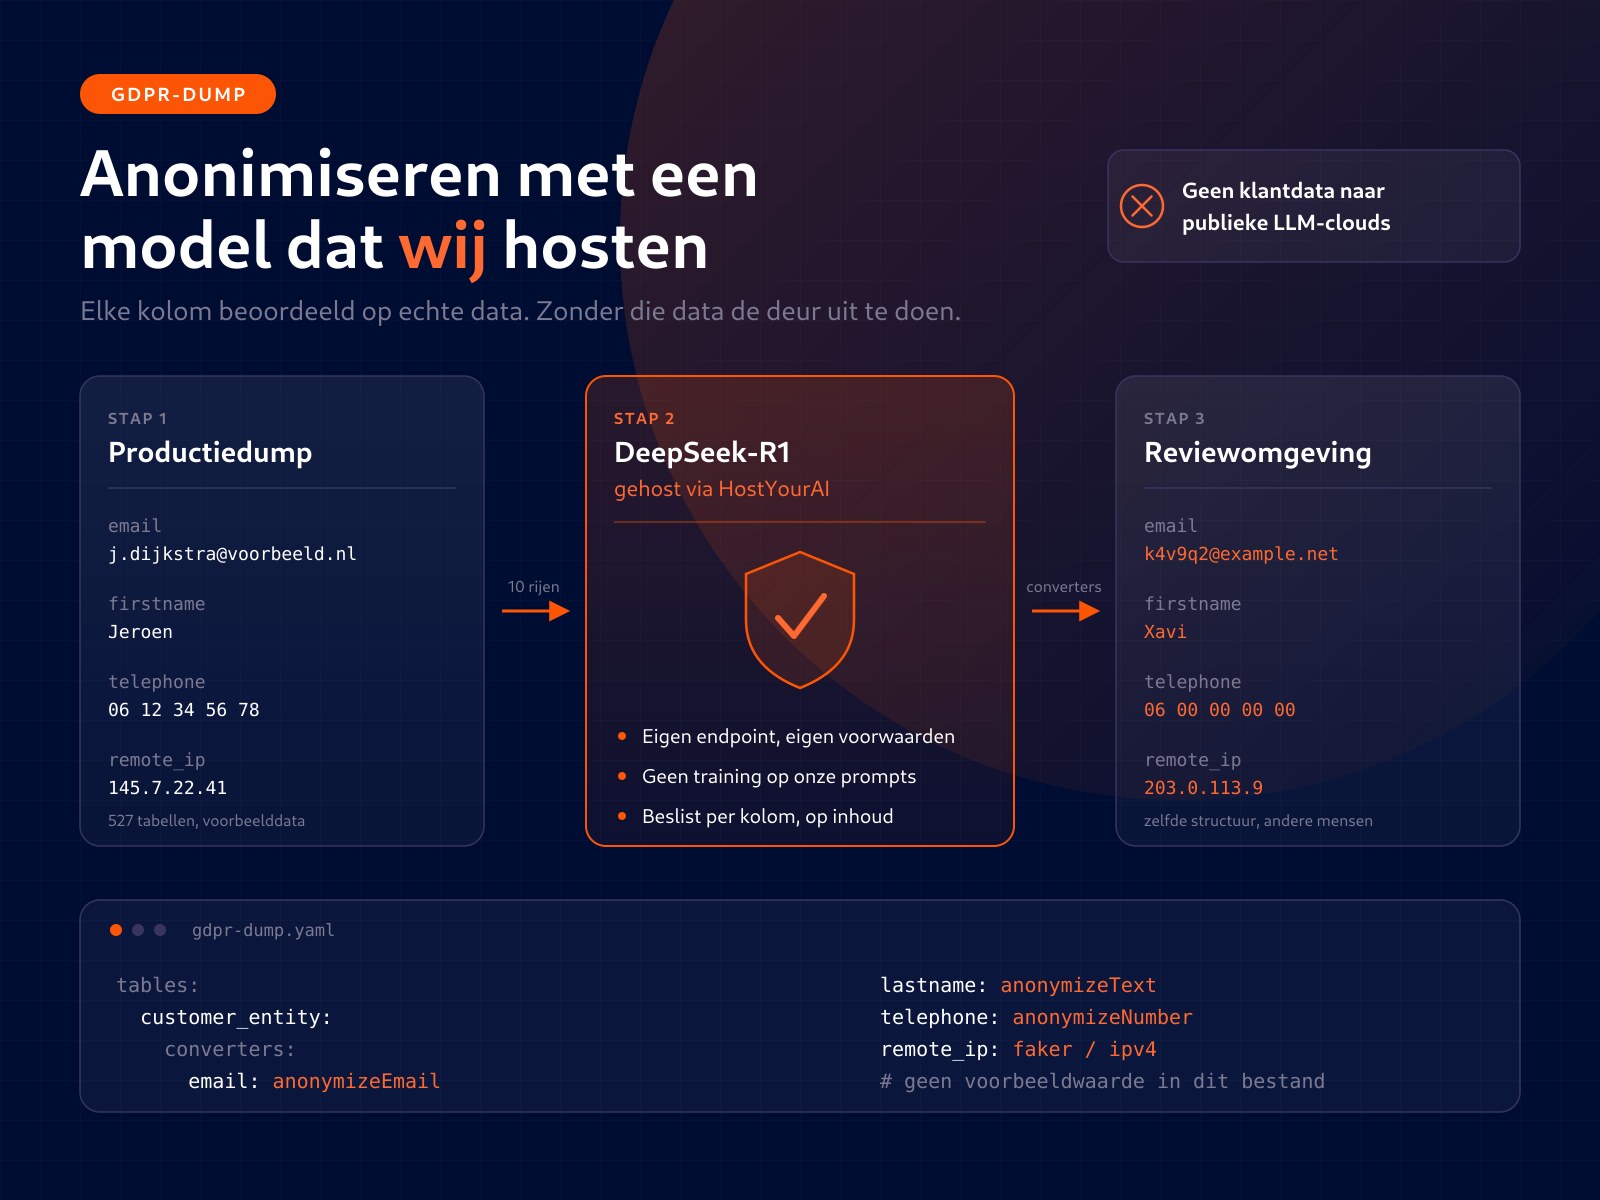
Het vervangen zelf is een opgelost probleem. gdpr-dump van Smile leest je database, vervangt waarden per kolom met een converter en schrijft een schone dump weg. In een YAML-bestand vertel je welke kolom welke behandeling krijgt.
Dat YAML-bestand is het werk. Een Magento-database heeft al snel vijfhonderd tabellen. Kolomnamen helpen daarbij maar tot op zekere hoogte. Een kolom die value heet kan in de ene tabel een achternaam bevatten en in de andere een productgewicht. Bij een betaling zit in additional_information soms een volledige adresregel. En andersom ziet customer_id er persoonlijk uit. Dat is een getal dat je juist met rust moet laten. Anders hoort geen enkele order meer bij een klant.
Daarom kijken we naar de data, niet naar de kolomnaam
Per tabel doen we twee dingen: we vragen de structuur op en we halen tien echte rijen op. Die combinatie gaat naar een taalmodel met een vraag. Welke van deze kolommen bevatten persoonsgegevens, en welke converter hoort erbij?
Het model ziet daardoor dat dezelfde kolomnaam in de ene tabel achternamen bevat en in de andere gewichten. Dat krijg je met een lijst kolomnamen of een setje reguliere expressies nooit betrouwbaar voor elkaar. Zeker niet bij modules van derden, die hun eigen tabellen meebrengen.
En daar zit het risico
Om een model te laten oordelen over echte data, moet je die echte data laten zien. Stuur je dat naar OpenAI, Anthropic of Google, dan verlaat elke voorbeeldrij je eigen omgeving. Vanaf dat moment gelden de voorwaarden, de bewaartermijnen en de subverwerkers van een partij waar jij geen zeggenschap over hebt.
Dat is een vreemde ruil. Je bouwt een pijplijn om te voorkomen dat klantgegevens op de verkeerde plek belanden, en in de eerste stap van die pijplijn stuur je precies die gegevens naar een Amerikaanse API. Het probleem is dan niet opgelost, alleen verplaatst.
Daarom hosten we het model zelf, via HostYourAI
We gebruiken een open model op eigen infrastructuur: DeepSeek R1, in de gedistilleerde variant op Qwen 32B, gehost via HostYourAI. Dat is een eigen endpoint met een eigen key. De voorbeeldrijen gaan naar een machine waarvan we weten waar hij staat en wie erbij kan, en niet naar een dienst die onze invoer kan gebruiken voor een volgende modelversie.
Dat het een open model is, maakt die keuze pas mogelijk. Een proprietary model kun je alleen gebruiken op de infrastructuur van de eigenaar. Dat is de afspraak. Bij open gewichten bepaal jij waar het draait, en kun je van leverancier wisselen zonder je pijplijn opnieuw te bouwen.
Voor deze taak is het ook ruim voldoende. Het model schrijft geen code en bedenkt niets. Het krijgt tien rijen en geeft per kolom een oordeel terug. Dat is classificatie, en daar is een model van deze omvang goed in. Het scheelt bovendien geld, want vijfhonderd tabellen zijn duizenden calls, per project.
Hoe de pijplijn eruitziet
De stappen zijn voor elk project gelijk:
- de gestripte dump ophalen uit onze backupopslag
- importeren in een tijdelijke database, nooit in een bestaande
- per tabel de structuur en tien rijen ophalen
- het oordeel van het model per tabel wegschrijven als los YAML-fragment
- de fragmenten samenvoegen tot een gdpr-dump.yaml
- de tijdelijke database weggooien
Een fragment per tabel klinkt omslachtig. Het zorgt ervoor dat een run van vijfhonderd tabellen hervat kan worden als er halverwege iets misgaat. Een wrapper eromheen doet hetzelfde voor al onze klantprojecten achter elkaar.
Twee dingen die we onderweg leerden
Het eerste: laat identifiers met rust. Een model dat op inhoud oordeelt, merkt customer_id, increment_id of coupon_code nog weleens aan als persoonsgegeven. Anonimiseer je die, dan houd je een database over waarin niets meer bij elkaar hoort. Het antwoord van het model gaat daarom achteraf langs een lijst met kolommen die nooit vervangen mogen worden.
Het tweede was een fout van onszelf. We vroegen het model om bij elk oordeel een korte motivatie, en die motivatie zetten we als commentaarregel in de YAML. Dat leest prettig, tot je ziet wat er staat: bevat telefoonnummers zoals 06 12 34 56 78. Daarmee stond er een echte waarde uit de productiedatabase in een configuratiebestand dat in git zit.
Dat is precies het lek dat de pijplijn moest voorkomen. Het ontstond zoals dit soort lekken vaak ontstaan. Niet bij de data zelf, maar in iets eromheen dat handig leek. Het model krijgt nu de opdracht om nooit een waarde over te nemen, en het bestand bevat alleen nog kolomnamen en converters.
Wat het oplevert
Elk project heeft nu een gdpr-dump.yaml in de repository. Komt er een nieuwe dump, dan loopt het anonimiseren mee in het proces. De reviewomgeving krijgt data die realistisch genoeg is om mee te testen, en die niet naar een persoon leidt.
De winst zit niet in dat bestand. Die zit erin dat niemand meer hoeft af te wegen of het deze ene keer wel kan. Wil je weten hoe we dit voor jouw platform inrichten? Neem contact op.